
可观测性亟需范式转移:从数据堆积到目标驱动的智能分析
拥有三十余年IT运维经验的作者认为,当前可观测性实践未能解决根本问题,反而因数据爆炸、工具碎片化和人工排障负担加重而恶化。文章提出从自下而上的数据收集转向自上而下的目的驱动分析,并探讨Causely的范式转移理念及Agentic AI在IT运维中的潜力。
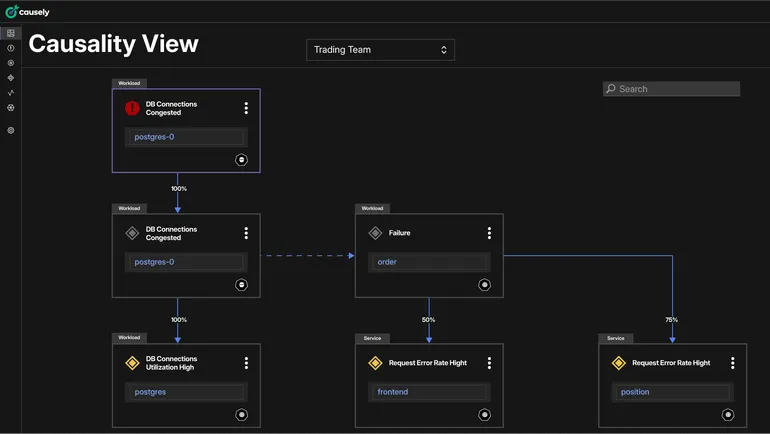
我在IT运维领域已深耕三十余年。尽管业界充斥着“转型”的论调,但许多根本性挑战并未得到解决,甚至有所加剧。现代DevOps与可观测性的兴起曾承诺彻底改变系统监控与维护方式,然而现实是,我们只是将旧问题规模化放大:更多的数据、更多的仪表盘、更多的告警,并未带来更好的结果。
核心问题在于:我们对可观测性的理解存在偏差。我们需要从自下而上的方法转向自上而下的范式转移。与其自下而上地收集一切数据、期望从中发现洞察,不如从目标或所需洞察出发,仅采集有助于推断这些洞察的数据。
第一部分:回顾IT运维的早期岁月
从IT运维的早期开始,我们一直专注于“维持系统运行”。彼时系统多为单体架构,监控手段原始,故障排查往往需要工程师花费数小时翻阅日志文件。重大事故意味着一个“作战室”里挤满工程师,手动关联数据,试图定位宕机的根本原因。
随着基础设施日益复杂,行业应对方式是叠加更多工具,每个工具都承诺简化排障流程。但实践中,这些工具常常只是制造更多仪表盘、更多日志和更多告警,导致信息过载。IT运维需要进化,这催生了现代DevOps,但我们仍处于这场变革的早期阶段。
第二部分:当前可观测性的问题
可观测性本应通过让团队更深入地理解系统来解决上述挑战。其理念是:通过收集和分析海量遥测数据(指标、事件、日志和链路),组织能获得更好的洞察并更快响应问题。
然而,我们看到的却是复杂性的爆发。当今可观测性领域呈现以下特征:
- 噪音过多:日志和告警的庞大体量使工程师几乎无法从数据洪流中分离出有意义的信号。
- 工具过多:企业依赖监控、日志和链路追踪解决方案的碎片化生态,导致数据孤岛和效率低下。
- 人工排障过多:尽管数据丰富,工程师仍将大部分时间用于手动诊断事件、关联日志和响应误报。
可观测性的承诺并未完全兑现,因为组织仍聚焦于数据收集,而非转向智能数据处理。
第三部分:Causely的范式转移
在Causely,我们认为可观测性必须被颠覆,并经历从自下而上的数据收集到自上而下的目的驱动分析的范式转移,从而将工程师从数小时的数据筛选中解放出来,让他们不必再寻找“现象背后的原因”。我们拒绝接受工程师永远需要花时间钻取仪表盘、理解工具数据的观点。相反,我们相信实施适当的抽象层能让系统自我管理,并将人类从故障排查循环中移除。工程师不应使用提供信息供人分析的工具,而应部署能够自主决策的系统。
这条通往自主服务可靠性的道路建立在若干核心原则之上,我在近期博客中已概述。从被动收集数据转向依赖主动解释并执行洞察的系统,是可观测性的未来。
第四部分:AI与Agentic AI的崛起
我们正处于一个新时代的临界点,Agentic AI可以从根本上重塑IT运维。不再是工程师对告警做出反应,AI驱动的系统将主动维护服务可靠性,在故障发生前预测并预防。
我指的不是简单的告警规则或异常检测,而是真正的Agentic AI——它能持续分析系统行为,并实时调整以防止服务降级。
Causely已准备好引领这一变革,帮助组织从被动排障转向主动的、AI驱动的服务可靠性。这不仅是可观测性的一次进步,更是我们对IT运维思考方式的范式转移。
结论
三十多年来,我们一直在IT运维中应对同样的挑战,只是规模更大。是时候重新思考可观测性,超越无休止的数据收集,拥抱一个由AI驱动自动化确保服务可靠性、且只需最少人工干预的未来。采用这一新范式的组织不仅能减少停机时间和事件成本,还能让工程师专注于真正重要的事:构建未来。